RTX 3090 LLM-benchmark: 70B på 48 GB och 32 samtidiga användare
Lokala LLM-benchmark på två RTX 3090 med CRUCIBLE. 19–145 tokens/s för en användare, 2 460 tokens/s för 32 samtidigt, plus citerade svar från egna dokument.
Har du kört lokala modeller har du säkert ställt dig frågan någon gång: vad ger den här maskinen mig egentligen? Inte marknadsföringssiffran för ett kort, utan vad en riktig låda presterar med en riktig modell framför riktiga människor. Vi ville ha ett ordentligt svar för vår egen hårdvara, så vi mätte det noggrant och skrev det inlägg vi själva hade velat läsa.
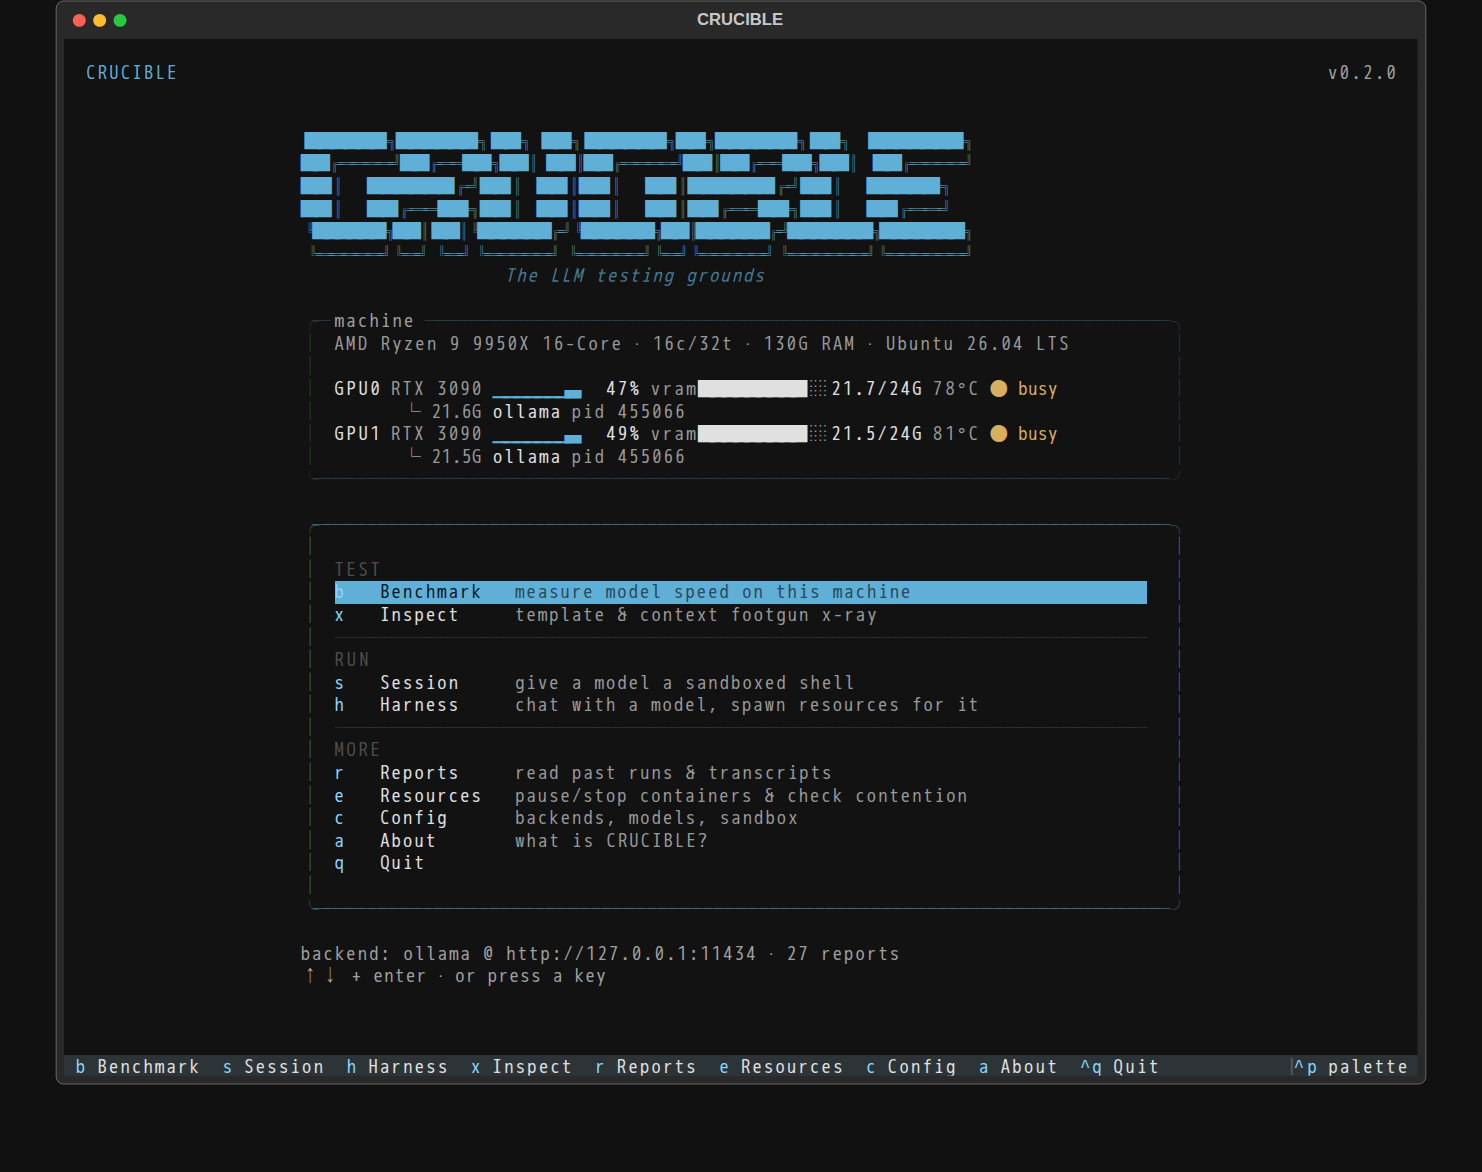
Allt här mättes med CRUCIBLE, så det är värt en stund att förklara vad det är innan siffrorna.
Vad CRUCIBLE är
CRUCIBLE är ett terminalverktyg för att benchmarka lokala LLM:er. Vi byggde det medan vi testade modeller för vår egen stack, tröttnade på att gissa vilken modell som skulle kännas snabb på vilken hårdvara, och landade i något som var värt att släppa. Det är öppen källkod, MIT-licensierat och finns på GitHub: github.com/AthlasSoftware/crucible.
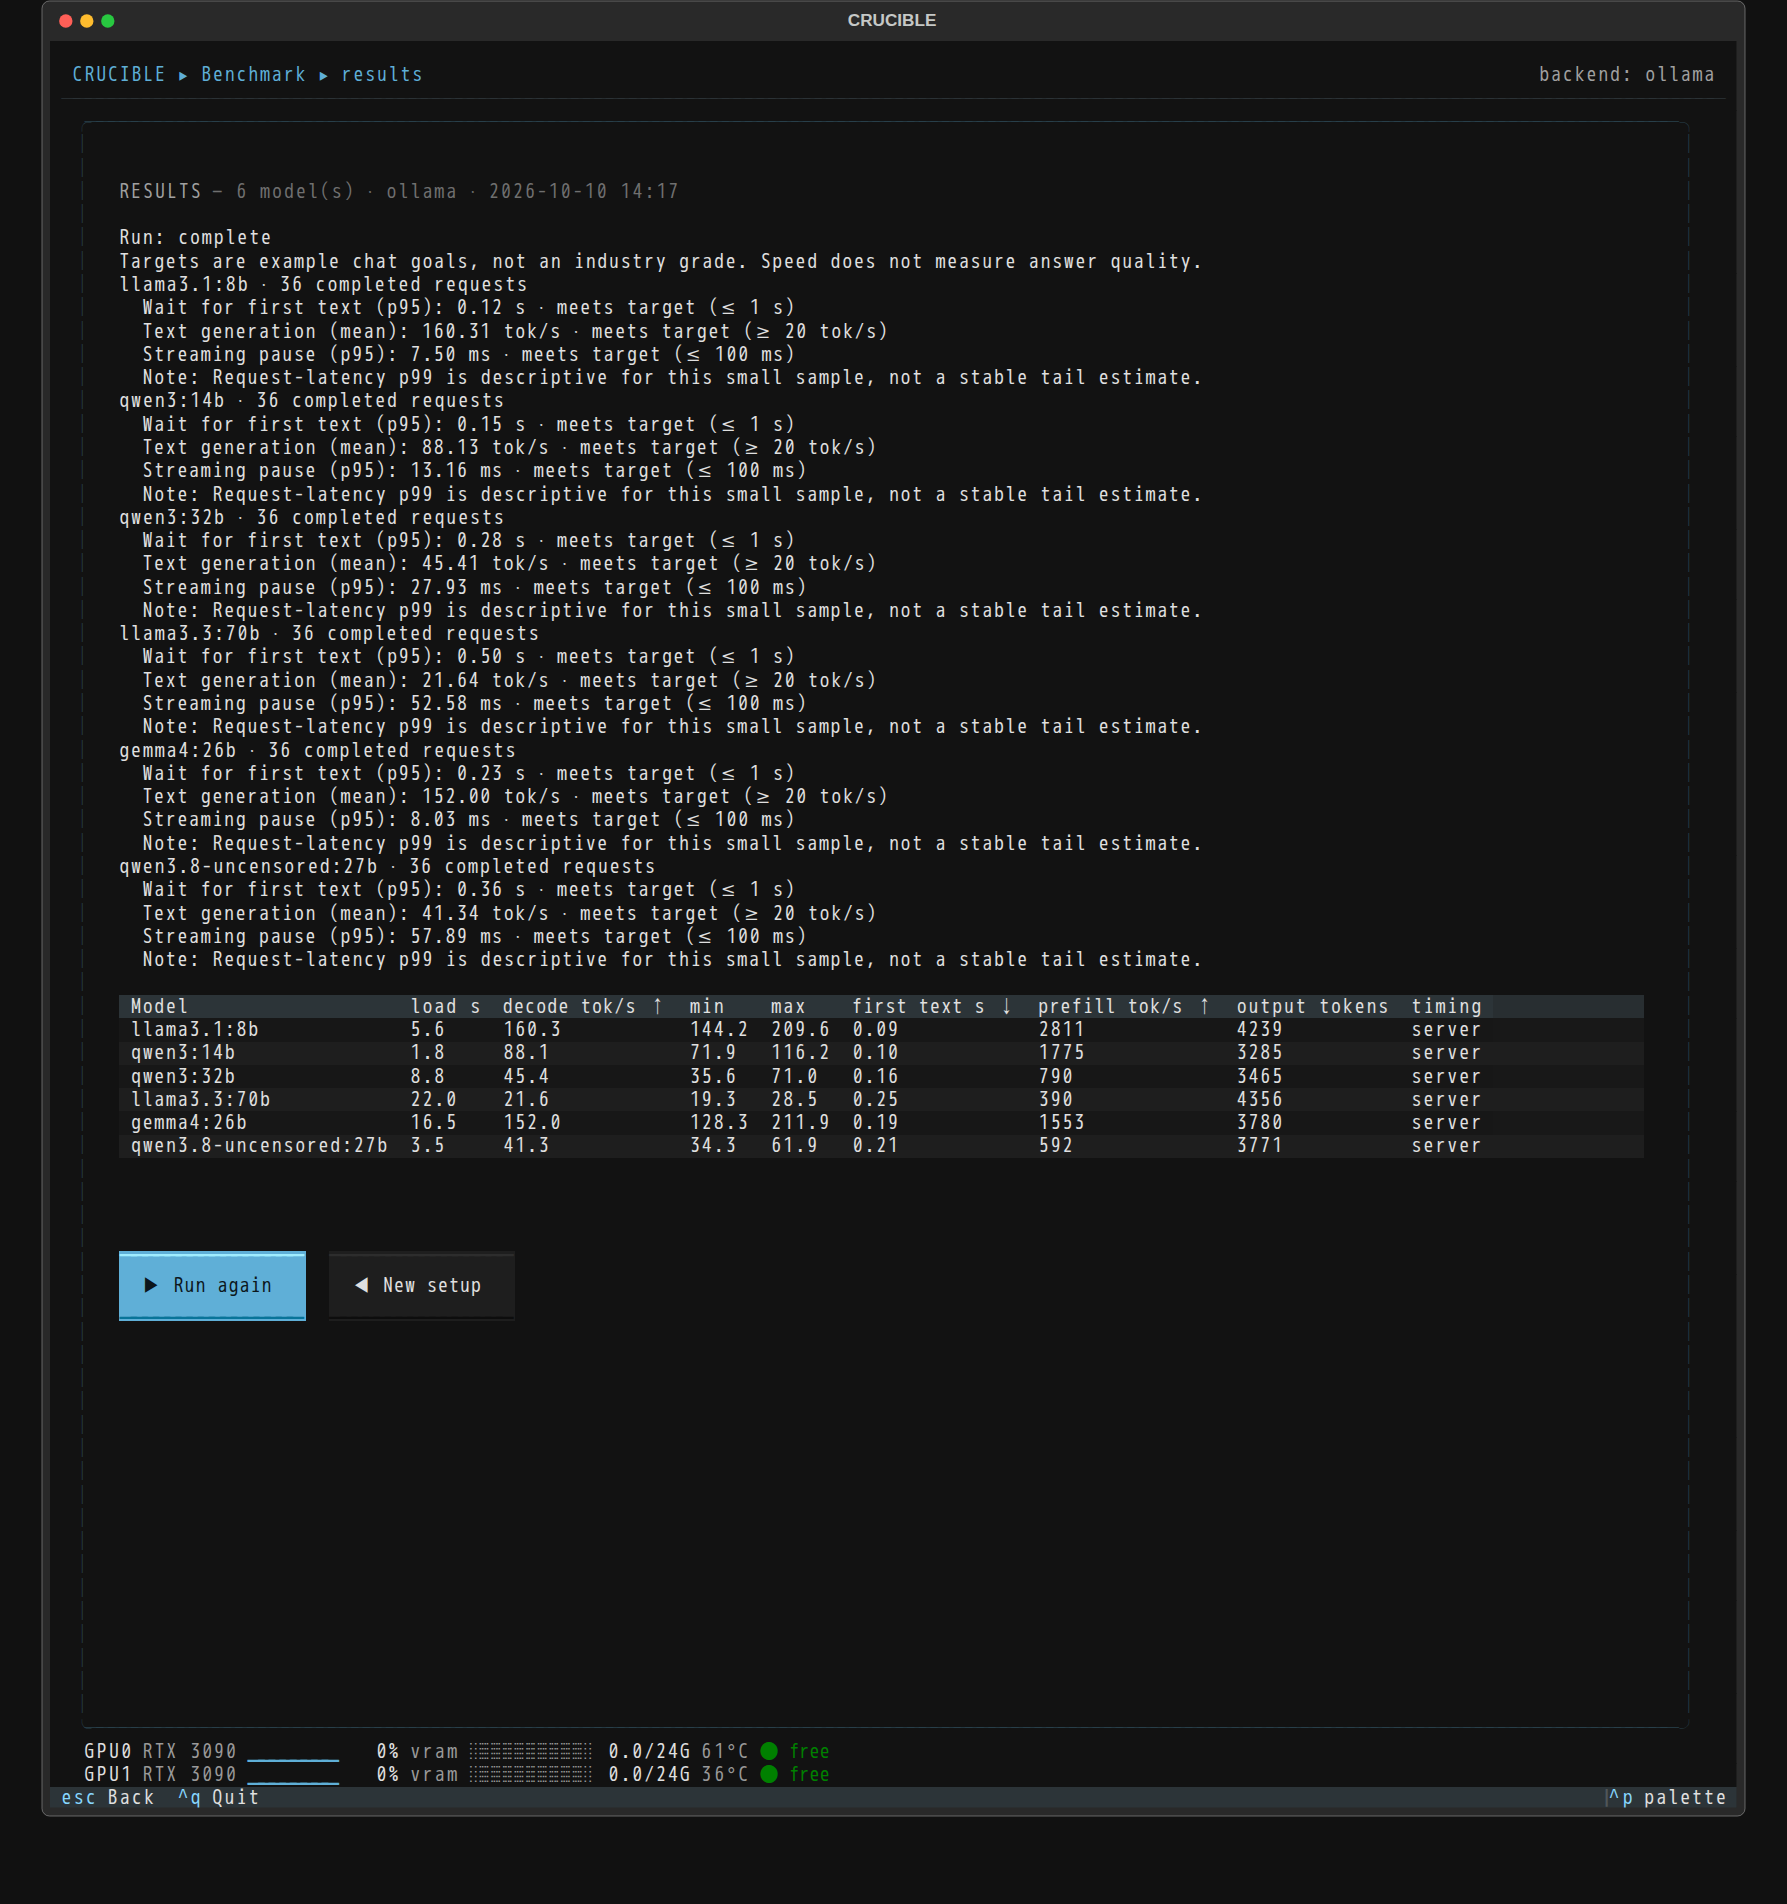
Det fungerar mot Ollama, vLLM och alla OpenAI-kompatibla servrar. Det som skiljer det från att pipa siffror ur ett skript är att det förklarar dem. En körning berättar hur länge du väntar på det första ordet, hur snabbt modellen avkodar efter det och om strömmen hackar, sedan säger den om de siffrorna uppfyller de mål du satt och var underlaget är tunt. Varje körning sparar en JSON- och Markdown-rapport med den kontext som behövs för att kontrollera den senare: antal stickprov, osäkerhet, tokenintervall, slutförandestatus. Det är ärligt om sina egna begränsningar, vilket för ett benchmarkverktyg är hela poängen.
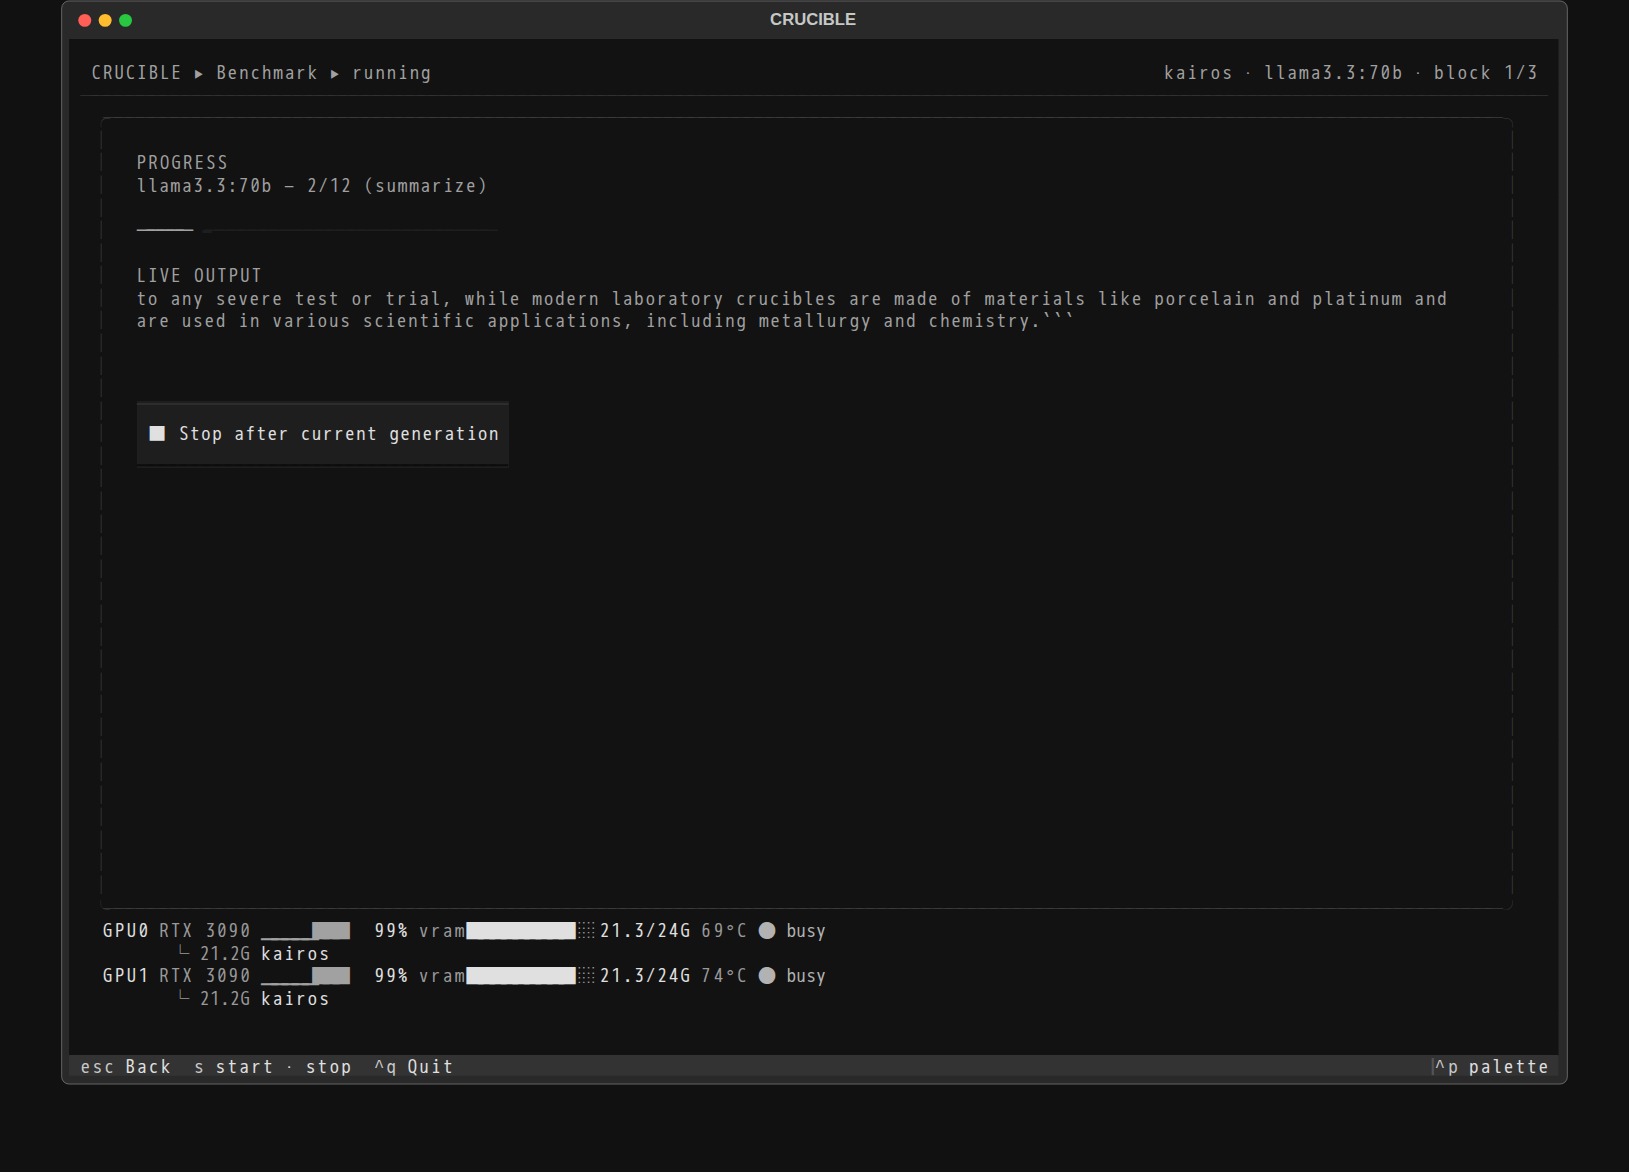
Att köra det är tre rader:
git clone https://github.com/AthlasSoftware/crucible.git
cd crucible
uv run crucible
Du behöver uv, Python 3.12+ och en modellserver. Det är hela uppsättningen. Allt nedan kom ur den.
Maskinen
Vår testbänk: en AMD Ryzen 9 9950X, 128 GB RAM, två RTX 3090 med 24 GB vardera, på Custom KairosOS-varianten. En sak att vara tydlig med på förhand, eftersom resten av inlägget lutar sig mot det. Det här är vår utvecklingsmaskin, inte en produkt. Den har samma form med två GPU:er och 48 GB som Blackbox Base-nivån, men på föregående GPU-generation. De maskiner vi faktiskt levererar kör nuvarande Blackwell-kort. Så varje siffra här är ett golv, inte ett tak.
Inlägget har två delar. Först råmetall: en modell, en användare, direkt från Ollama, vilket är den baslinje de flesta känner igen. Sedan samma maskin som servar ett rum fullt av människor via Kairos, vårt programvarulager, vilket är hur ett team verkligen använder en sådana lådor.
Del ett: råmetall
Hur vi mätte
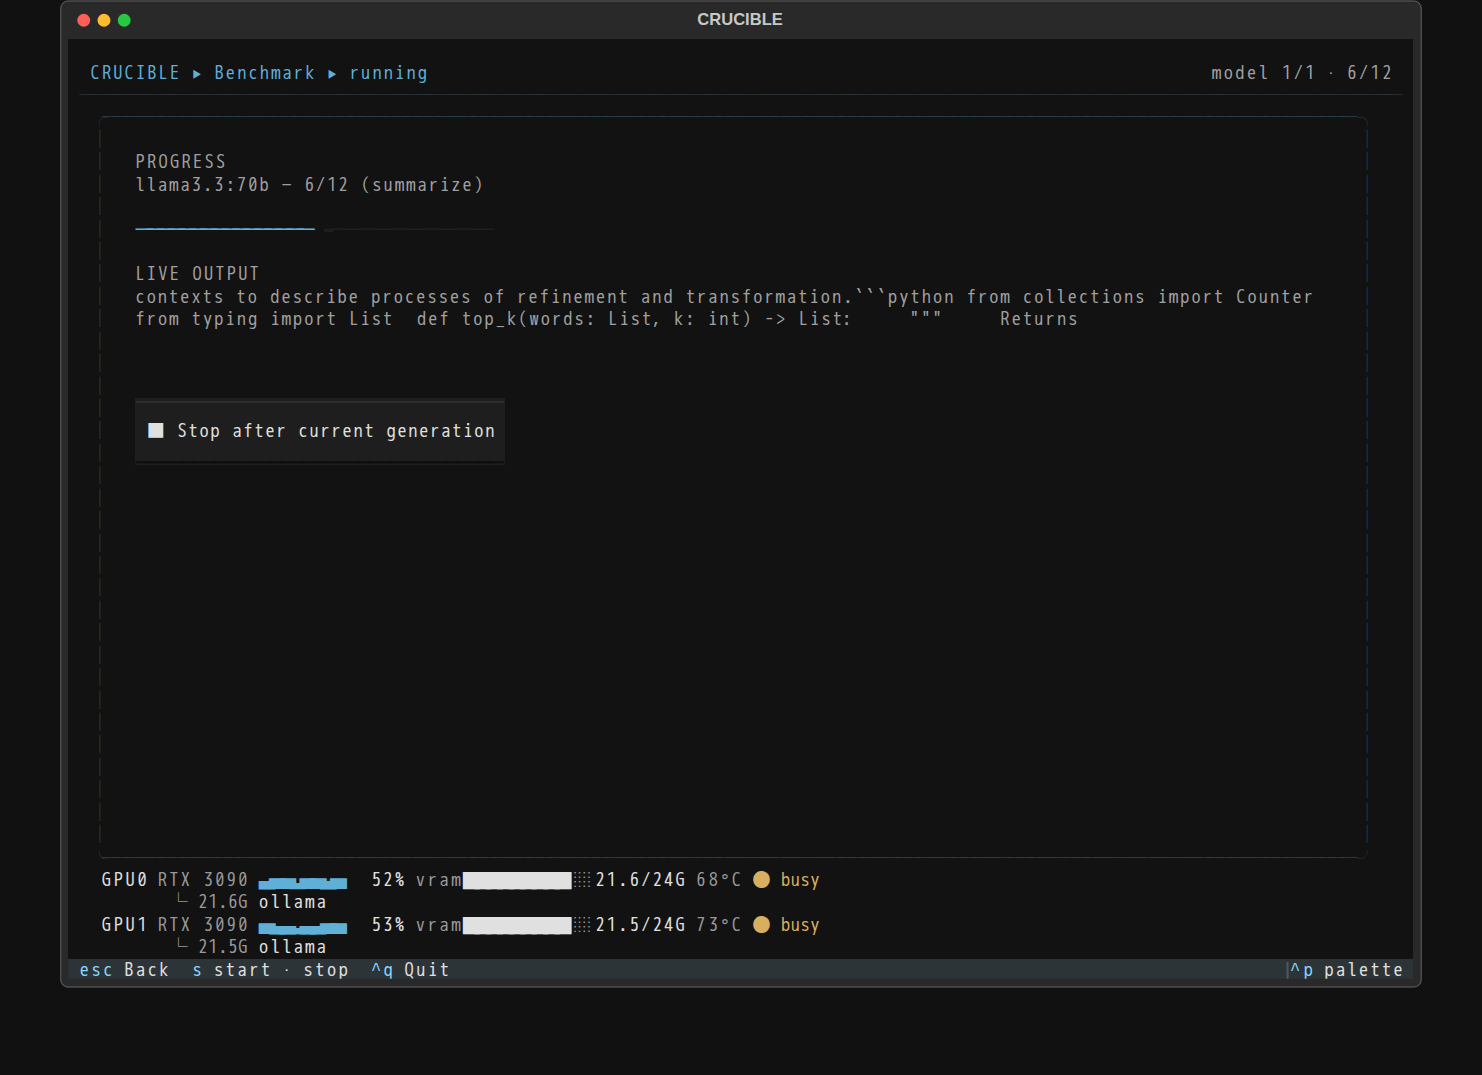
Ollama 0.23.2, modeller på 4-bit, kontext 8192, temperatur 0, ett fast frö och ett uppvärmningspass innan varje körning så att en kall laddning inte snedvrider det första resultatet. Tre block per modell. För avkodningshastighet använder vi CRUCIBLEs fasta 128-tokengenerering så att varje modell gör samma mängd arbete. Inget serveringslager framför modellen, en förfrågan i taget. Det här är baslinjen som resten av inlägget mäts mot.
Vad varje modellstorlek levererar
| Modell | VRAM använt | Första token, p50 / p95 | Prefill (tok/s) | Avkodning (tok/s) |
|---|---|---|---|---|
| Llama 3.1 8B | 5,9 GB | 0,08 s / 0,12 s | 4 605 | 145,2 |
| Qwen3 14B | 10,0 GB | 0,09 s / 0,15 s | 2 554 | 78,7 |
| Gemma 4 26B | 18,3 GB | 0,18 s / 0,23 s | 3 251 | 134,0 |
| Qwen3 32B | 21,1 GB | 0,12 s / 0,28 s | 1 120 | 36,9 |
| Llama 3.3 70B | 21,7 + 21,5 GB | 0,17 s / 0,50 s | 563 | 19,4 |
Avkodningssiffrorna är tg128-medelvärden och de höll sig stabila, under 0,3 tokens per sekund i variation mellan körningar för varje modell.
Får en 70B verkligen plats på 48 GB?
Det gör den, med tillräckligt med utrymme för att vara användbar snarare än bara tekniskt möjlig. På 4-bit tar Llama 3.3 70B 21,7 GB på ett kort och 21,5 GB på det andra, kör båda för fullt och håller 19,4 tokens per sekund. Den mediala första token anländer på 0,17 sekunder. De flesta läser ungefär 5 till 7 tokens per sekund, så även på två andrahandskonsumentkort svarar en 70B snabbare än du kan hänga med.
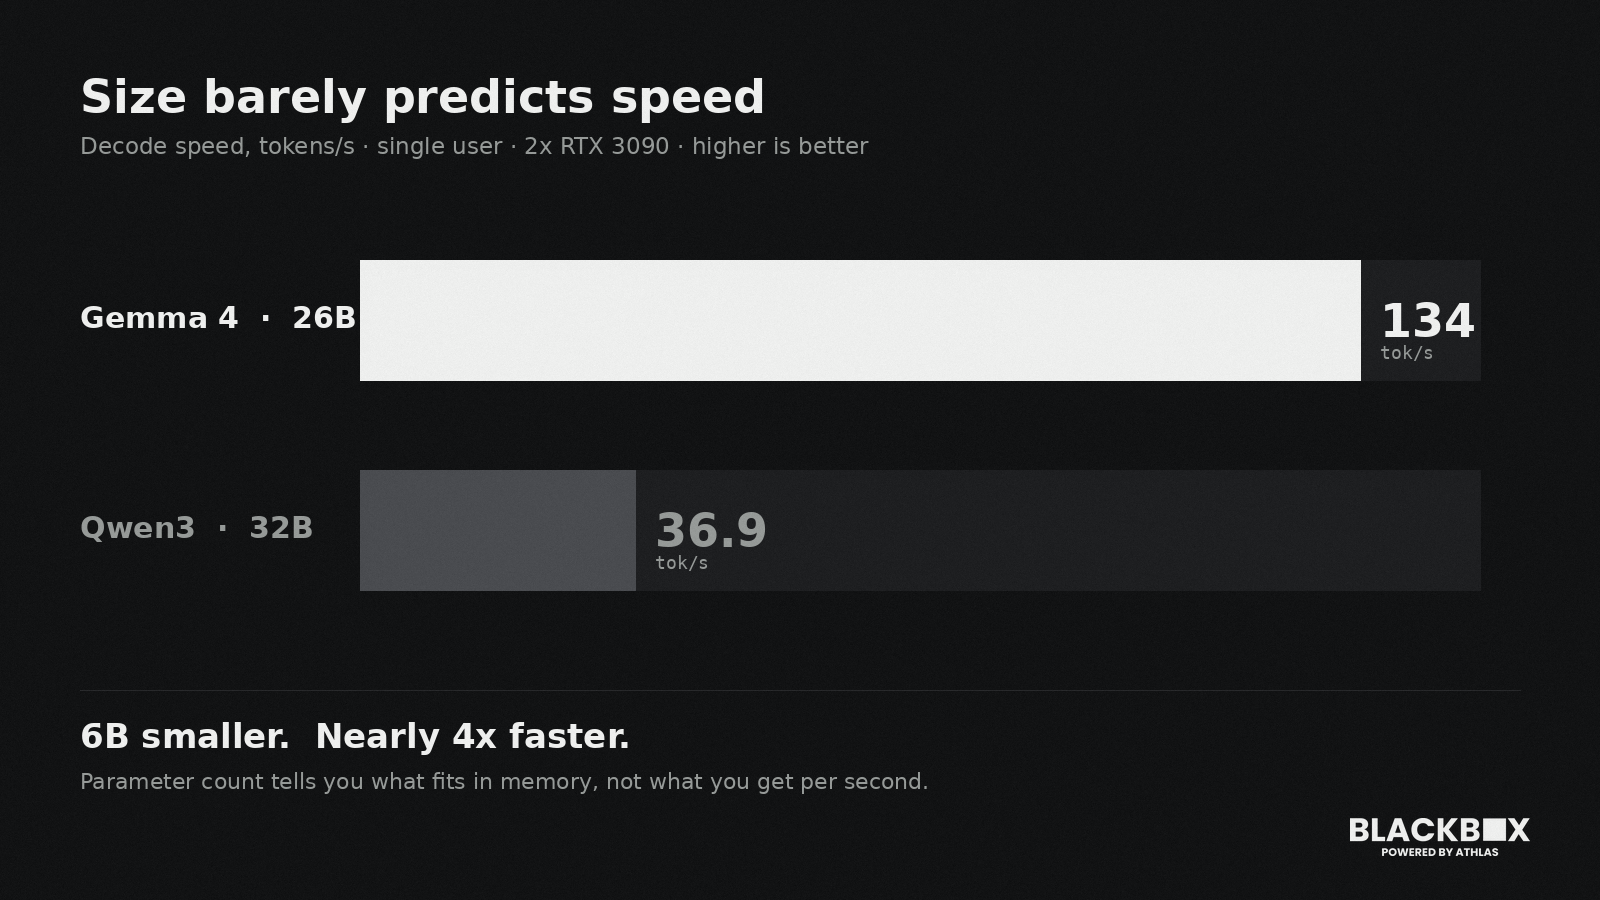
Varför en 26B kör nästan 4x snabbare än en 32B
Det här var det mest användbara råkörningen berättade för oss, och det tydligaste argumentet för att mäta i stället för att lita på ett datablad.
Titta på de två modellerna på papper. Gemma 4 på 26B och Qwen3 på 32B är tillräckligt nära varandra i storlek för att du skulle förvänta dig att de känns ungefär likadana, med 32B kanske lite långsammare för att den är större. En 6B-skillnad av trettio är inte mycket. De flesta skulle gissa några tokens per sekund mellan dem.
Den verkliga skillnaden är inte några få. Gemma 4 26B avkodar med 134 tokens per sekund. Qwen3 32B klarar 36,9. Den mindre modellen är nästan fyra gånger snabbare, på samma kort, samma inställningar, samma prompt. Sex miljarder parametrar mindre på papper, nästan 4x snabbare i praktiken.
Anledningen är att parameterantal inte är ett hastighetsmått. Hur snabbt en modell avkodar beror på dess arkitektur och hur effektivt den körs på hårdvaran framför den, saker som ingen storleksetikett fångar. En modell som tränats för att vara effektiv vid inferens lämnar en större och tyngre långt bakom sig, och det kan du inte se från namnet.
För ett företag spelar det roll på ett mycket konkret sätt. Om du valde enbart efter storlek skulle du kunna sätta den långsammare 32B på din maskin, ge ditt team en assistent som känns seg och aldrig inse att en modell sex miljarder parametrar mindre hade svarat nästan fyra gånger snabbare och frigjort kapacitet för fler samtidigt. Det enda sättet att veta vilken modell som faktiskt passar din hårdvara är att köra den där, vilket är precis vad CRUCIBLE är till för.
Del två: vad Kairos förändrar
Del ett är en person i taget. En Blackbox är tänkt att serva ett team, och det är jobbet vårt programvarulager Kairos gör. Samma maskin, samma modeller, den här gången mätt via den serveringsväg en riktig driftsättning använder. CRUCIBLE kan peka mot den vägen på samma sätt det pekar mot vad som helst som är OpenAI-kompatibelt, så metoden förändrades inte, bara vad som sitter bakom den.
Snabbare, även för en person
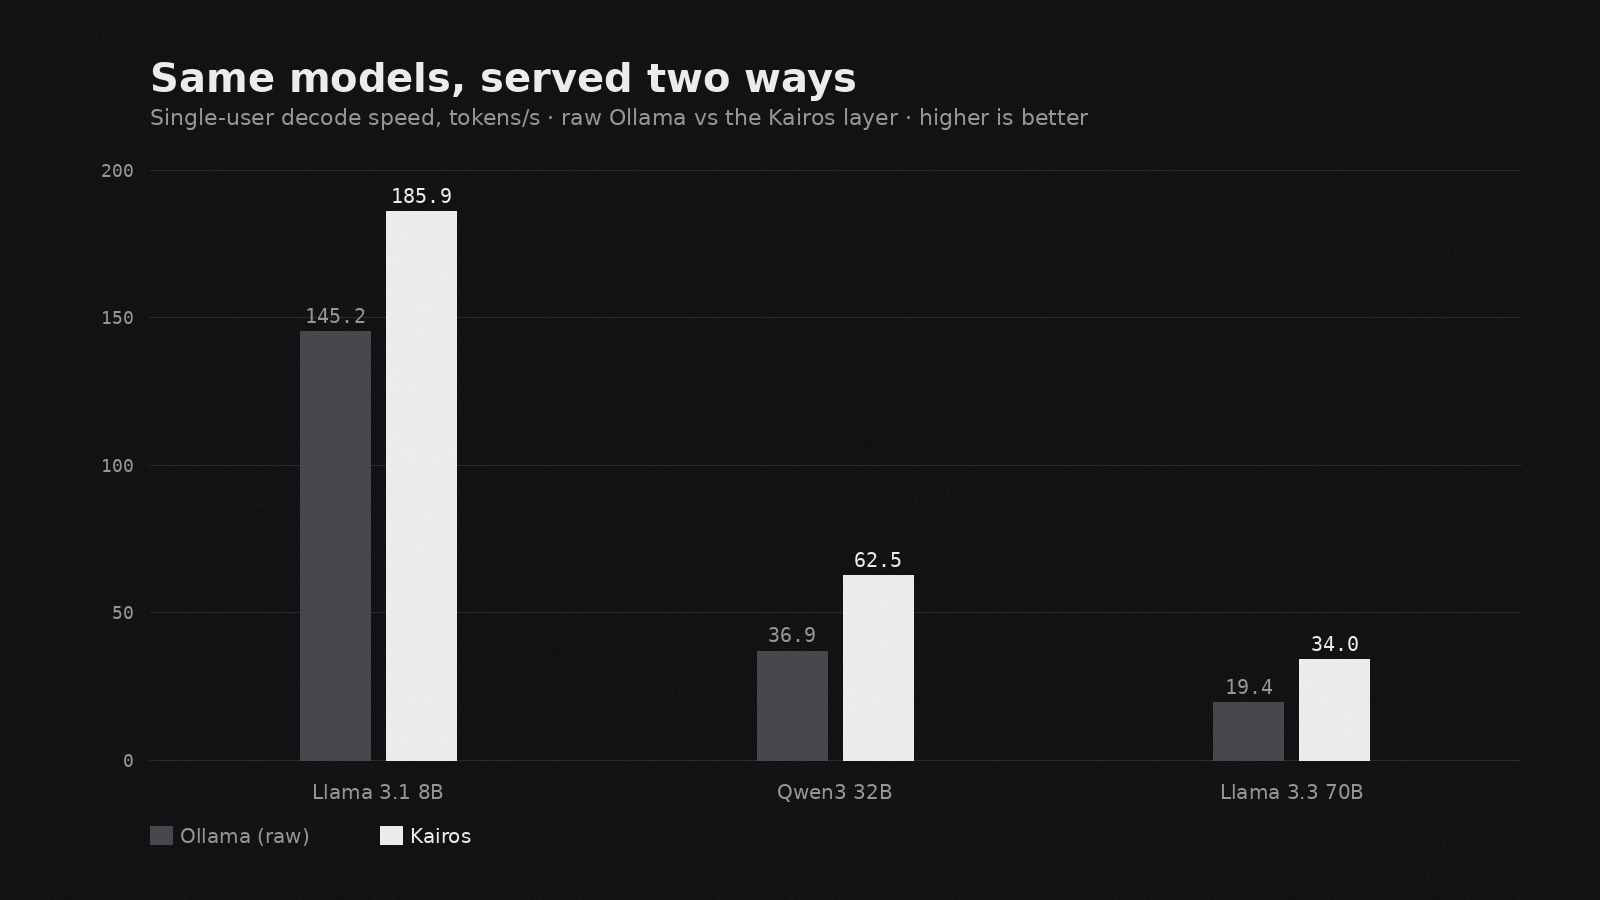
Den enklaste jämförelsen först: en enskild användare, rå Ollama mot Kairos, ingenting annat förändrat.
| Modell | Ollama (rå) | Kairos |
|---|---|---|
| Llama 3.1 8B | 145,2 tok/s | 185,9 tok/s |
| Qwen3 32B | 36,9 tok/s | 62,5 tok/s |
| Llama 3.3 70B | 19,4 tok/s | 34,0 tok/s |
32B kör ungefär 69 procent snabbare och 70B nära det dubbla, innan en andra användare är i närheten av maskinen. Väntetiderna förbättras också: 70B:s mediala första token sjunker från 0,17 till 0,07 sekunder.
Det håller när folk strömmar på
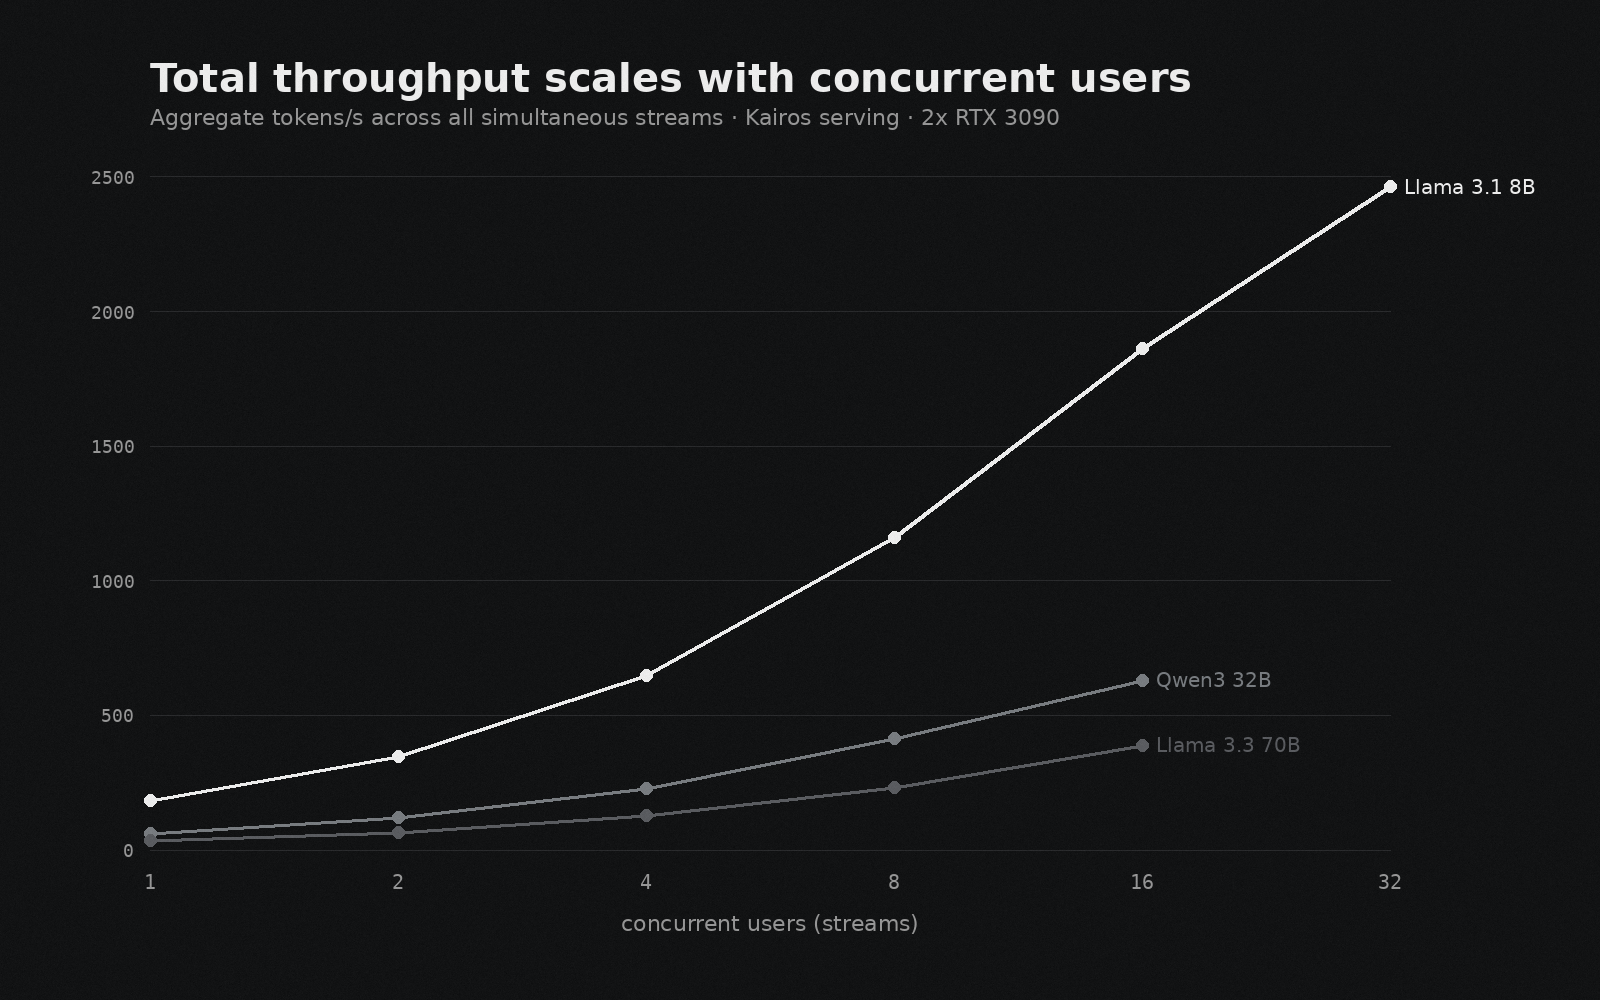
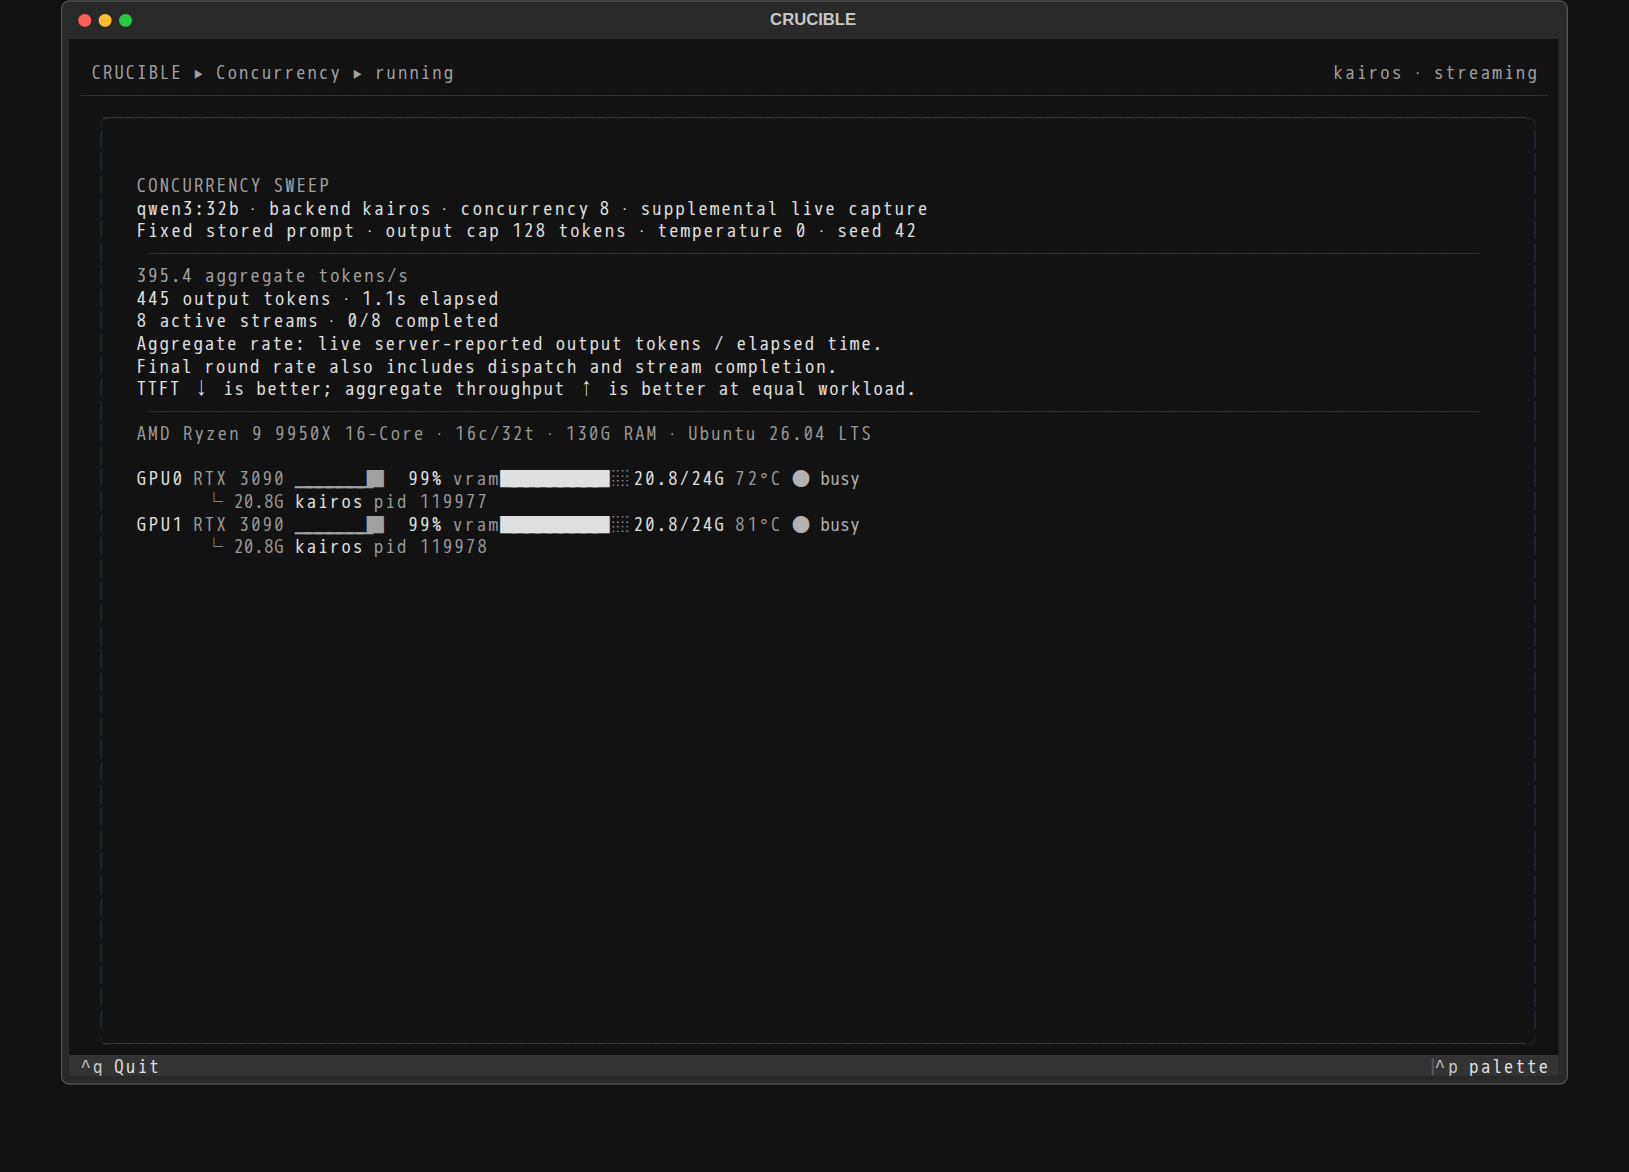
Det här är den del som spelar roll när fler än en person använder maskinen. När användare anländer samtidigt fortsätter det totala genomflödet att stiga, eftersom serveringslagret batchar deras förfrågningar tillsammans i stället för att köra dem en efter en.
En 8B-modell gick från 184 tokens per sekund för en användare till 2 460 för trettiotvå, alla samtidigt. En 32B bar 16 personer på 631 tokens per sekund kombinerat. 70B höll 388 tokens per sekund över 16 strömmar samtidigt. Varje persons eget svar blir lite långsammare när rummet fylls, men inte dramatiskt: en 8B-ström körde fortfarande på 117 tokens per sekund med 16 aktiva, bekvämt över läshastighet.
Vi körde samma test på rå Ollama för att ha något att jämföra mot. Vid fyra samtidiga 32B-strömmar misslyckades den i varje omgång. Det är skillnaden i praktiken mellan en modellserver och ett enkelvändarverktyg.
Fler användare, mindre energi per svar
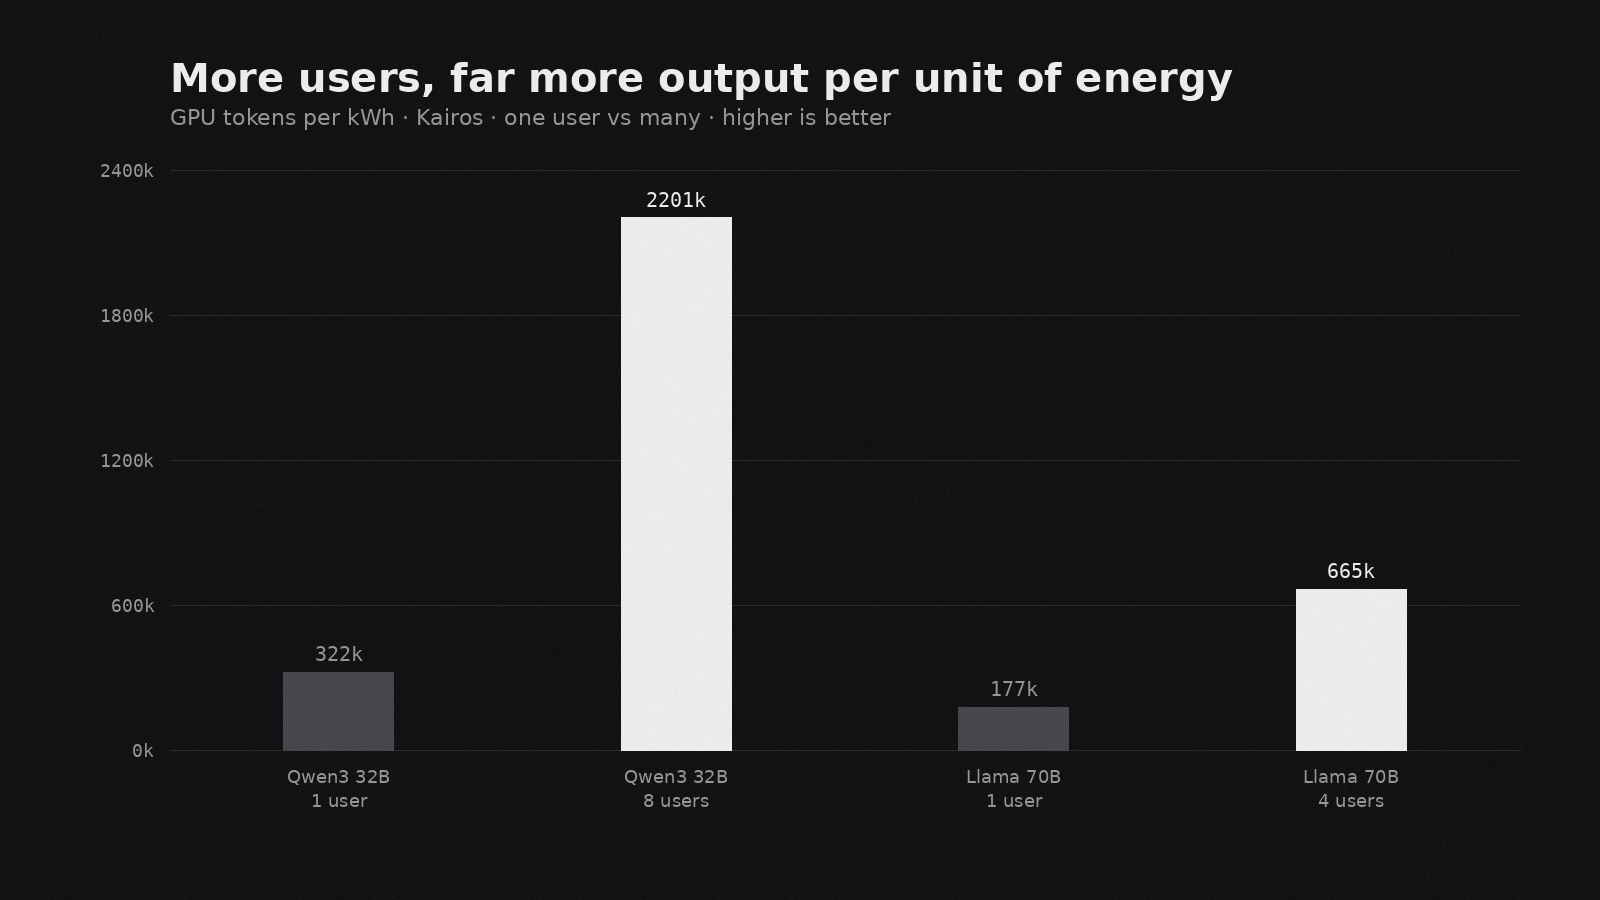
Den här fick oss att titta en gång till. Att serva många personer samtidigt använder långt mindre energi per svar än att serva en, eftersom GPU:erna uträttar mycket mer för ungefär samma effektuttag.
En 32B som servar en användare motsvarar ungefär 322 000 tokens per kilowattimme. Samma modell med 8 användare producerar ungefär 2,2 miljoner, nära sju gånger mer för samma energi. 70B följer samma linje, från 178 000 vid en användare till 666 000 vid fyra. Ju mer maskinen används, desto mindre kostar varje svar att producera.
Svar från dina egna dokument, med källor
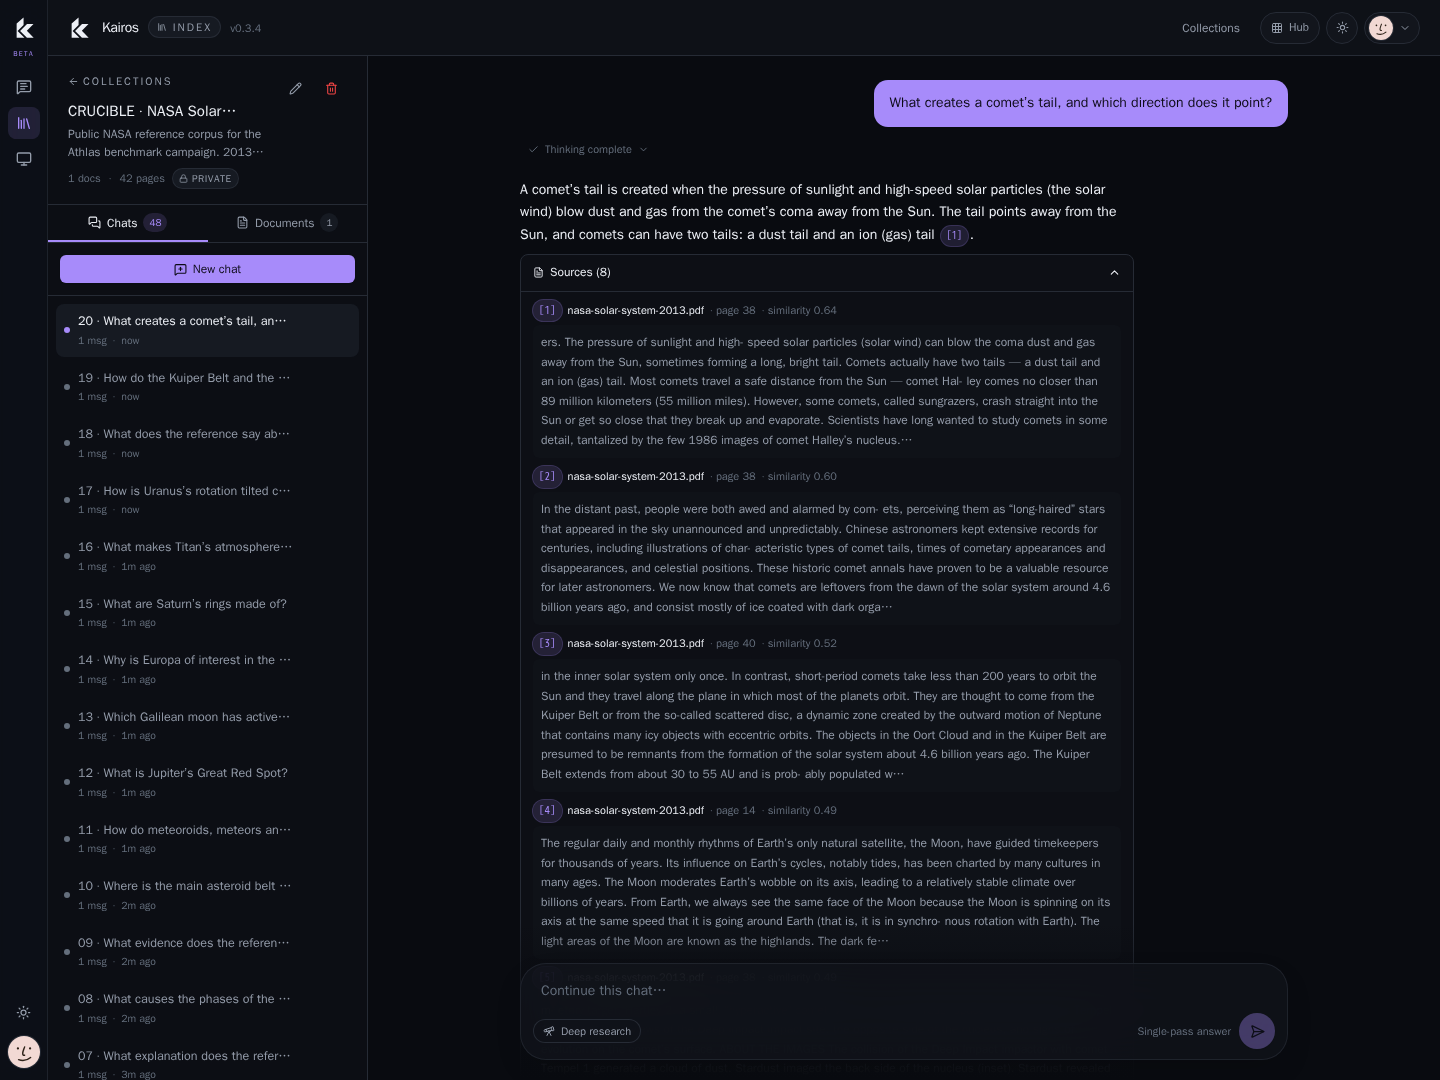
Hastighet är bara hälften av vad lagret gör. Index-verktyget svarar från ditt eget material och ingenting annat, lägger en källhänvisning på varje påstående och vägrar när dokumenten inte stöder ett svar i stället för att hitta på något.
Mätt på ett offentligt 42-sidigt NASA-referensdokument: fullständig inmatning på 25 sekunder, ungefär 100 sidor per minut, hämtning på under 0,13 sekunder och ett fullständigt citerat svar på ungefär 10 sekunder vid medianen. Alla 20 testfrågor kom tillbaka med sina källor bifogade. Det är löftet i klara siffror: fråga på vanligt språk, få ett svar du kan spåra tillbaka till en sida.
Begränsningarna hos dessa siffror
Ett benchmark är bara så bra som dess förbehåll, och CRUCIBLE är byggt för att hålla dem synliga. Råmetallsdelen är seriell, en användare i taget. Samtidighetskörningarna använder en fast kort prompt med ett 128-tokentak över tre omgångar, så de beskriver kapacitet vid dessa inställningar, inte det maximum maskinen någonsin skulle kunna nå. Tänklägen var avstängda för att hålla jämförelsen ren. Varje modell körde 4-bit, servad med produktionsekvivalenta inställningar. Vi mätte om svar kom tillbaka citerade och hur snabbt, inte om de var korrekta, det finns inget modellintelligensbetyg här. Effekt är GPU-kortets effektuttag, inte hela systemet. Och råkontrasten mot Ollama är en backend vid en inställning, inte en dom över Ollama, som är ett utmärkt enkelvändarverktyg som gör ett annat jobb.
De fullständiga rådata, varje förfrågningsspår, effektexemplen och skripten sparas och finns tillgängliga på begäran.
Prototypen och produkten
Allt här körde på förra generationens hårdvara, två begagnade 3090:or på en verkstadsbänk. Det rymmer ändå en 70B, servar ändå ett rum och svarar ändå från dina dokument med en källhänvisning. De Blackbox-maskiner vi levererar kör nuvarande Blackwell-kort över alla fyra nivåer, hyrda månadsvis med hårdvara, KairosOS, uppdateringar och support inkluderade. Läs dessa siffror som det golv produkten startar från.
Om du vill se vad leveransmaskinen gör med dina egna dokument, boka en 15-minuters demo. Om du bara vill mäta din egen hårdvara är CRUCIBLE gratis: github.com/AthlasSoftware/crucible.
Kör det själv
- Installera uv och ha Ollama eller vLLM igång.
git clone https://github.com/AthlasSoftware/crucible.gitcd crucible && uv run crucible- Öppna Benchmark, välj din modell, kör tre block och jämför mot tabellerna ovan.
Källor
Fortsätt läsa
Vill du ha hjälp med detta på riktigt?
Athlas bygger skräddarsydd mjukvara, AI-lösningar och digital marknadsföring för ambitiösa team. Hör av dig så ger vi ett rakt svar på om vi kan hjälpa er. Svar inom 24 timmar.